一个数据集,三个团队抢着用—算法研发要改标注,模型评测要锁定某次实验的输入,业务上线要确定到底用哪一版。刚开始大家还客客气气,用不了多久就会吵起来:谁把原始数据改了?这个结果对的是哪次实验?项目都结了,那堆副本到底还留不留?所谓“共享”,很快从容量问题变成管理问题。真正可持续的多项目共享,绝不是开一个公共目录让大家随便读写,而是从第一天起,就把版本、权限、副本和责任边界一起设计进去。
一 训练数据版本标识关联实验输入与结果
训练集通常由大量文件、标签、清洗结果和中间产物组成。只记录单个文件的修改时间,无法回答“这次训练到底用了哪一组数据”。因此,多项目共享首先需要数据集级的快照或版本标识,并把代码、参数、模型和评测结果与该标识关联。
数据版本工具可以把实验与特定修订关联。DVC通过版本元数据和远端存储协作,提供获取、推送和拉取数据等工作流,适合把数据引用纳入研发过程。在多人共用时,这类工具与底层存储分工:前者记录项目关系,后者提供实际内容、共享访问和数据保护。
一个成熟的数据资产还应带有最少元数据:来源、责任人、许可范围、创建时间、校验信息和保留期限。版本号只是入口,不能替代这些语义。若团队能回退数据,却不知道是否允许继续使用、是否包含敏感信息,版本管理仍没有解决真正的共享风险。
二 版本、权限和物理副本是三件不同的事
版本回答“用了哪一份”,权限回答“谁可以看和改”,副本策略回答“是否真的复制了一份数据”。三者常被混在一起:为了保护原始数据而复制目录,为了标识版本而改文件名,为了项目隔离而另建存储。结果是版本不可查询、权限难继承、容量不断膨胀。
更清晰的模型是保留一个受控的权威数据源,项目基于版本点创建工作视图或分支;读权限按数据域授予,写权限限定在项目空间;只有需要独立性能、合规或生命周期时才生成物理副本。项目合并前要经过数据负责人审核,项目退出后则按保留策略归档或删除派生数据。
权限宜面向角色和服务账号配置。训练作业读取基准集,标注任务写入指定工作范围,发布流程再让审核结果进入正式主线。企业可据此设计权威区、工作区和发布区,具体划分由数据治理制度与应用流程确定。
三 共享困难往往出现在并行修改和项目退出
两个项目从同一批样本出发,各自修正标签、增加素材,最难的不是保存文件,而是区分哪些变化可以合并、哪些存在冲突。直接覆盖公共目录会影响其他任务,复制完整目录又会不断占用空间。共享需要独立修改空间,也需要可以确定复现的稳定状态。
项目结束后,临时版本与正式基准不能一同无限保留。可以按实验关联、发布状态和保存要求确定保留规则,让仍有依据的历史版本继续可用,清理不再关联任务的中间结果。清理对象应是已确认退出的内容,不以删除一个标签代替完整的版本保留管理。
四 工具记录实验,存储组织共享,平台协调发布
数据版本工具路线适合已有成熟研发流程、希望用代码仓库关联数据的团队;存储分支路线将候选修改、稳定提交和批准合并放到数据底座,适合多个项目共用大量素材;平台组合路线则进一步整合目录、加工与资源调度。三者能够叠加,选择重点在于并行修改和发布责任由哪一层承担。
深信服aStor统一存储:对象数据分支与版本协作
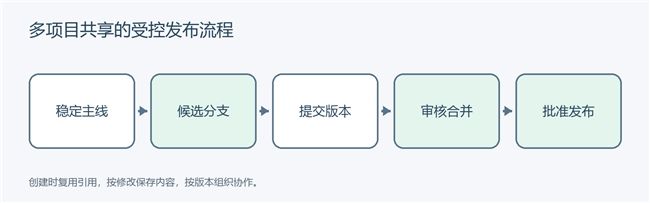
深信服aStor统一存储以块、文件、对象、向量底座同时承载传统与AI业务。在此底座上,针对普通对象桶和目录桶提供数据分支管理。创建候选分支时先复制数据引用,首次修改对象才保存变化内容;各团队在独立分支加工,未合并的修改不会影响正式主线。这比靠完整复制目录区分任务,更适合共享比例高、改动范围相对有限的数据集。
提交操作封存一个确定状态,后续写入进入新的暂存区;训练和评测记录提交编号,便能对应到当时的输入。稳定版本可加标签,受保护主线经审批合并后发布,出现问题可撤销指定提交的变化。它把“保存了一堆文件”进一步组织成“哪次修改已完成、哪个版本可使用”,为多团队协作提供清楚的数据交接点。
该分支机制的适用范围是普通对象桶和目录桶,不含NAS桶、向量桶。对外部向量索引、缓存和模型,上层流水线随数据版本联动更新;实验指标与模型注册也继续由研发平台管理。把这些分工在流程中明确后,数据回退与应用发布就能围绕同一版本引用协调。
五 从两个高重叠项目开始,把共享变成受控协作
如果本地项目多、数据重叠率高,而且希望减少整套拷贝,可以重点评估深信服aStor统一存储。经审核的基准数据作为主线,各项目从指定提交创建候选分支,完成标注或清洗后先评测再审批合并。实施时应明确适用的数据类型、发布责任和保留策略。
菲特(天津)检测技术有限公司采用深信服aStor统一存储支撑AI质检研发,CIFS、NFS连接标注工作站和训练服务器,共享目录减少了数据搬运,这类实践证明统一访问能改善研发协作。在采用新版本的数据分支能力时,企业还可以把协作规则进一步落实到候选、提交和批准发布。
现有存储已经满足性能与保护,团队也已使用DVC等工具时,可以继续完善实验追踪,减少改造范围。
总结
多项目AI共享不是开放一个公共盘,而是让数据来源、修改空间和发布状态都清楚。当多个项目共享大量基准数据、又需要控制修改与发布时,深信服aStor统一存储能够把分支、提交、审批和副本治理落到共同的数据底座上。