概述
近日,MLCommons 正式发布 MLPerf® Storage Benchmark 3.0(以下简称 “MLPerf Storage”)基准测试结果。XSKY (星辰天合)旗下 MeshFS 首次参赛,即在并行文件存储赛道一举拿下九项第一。
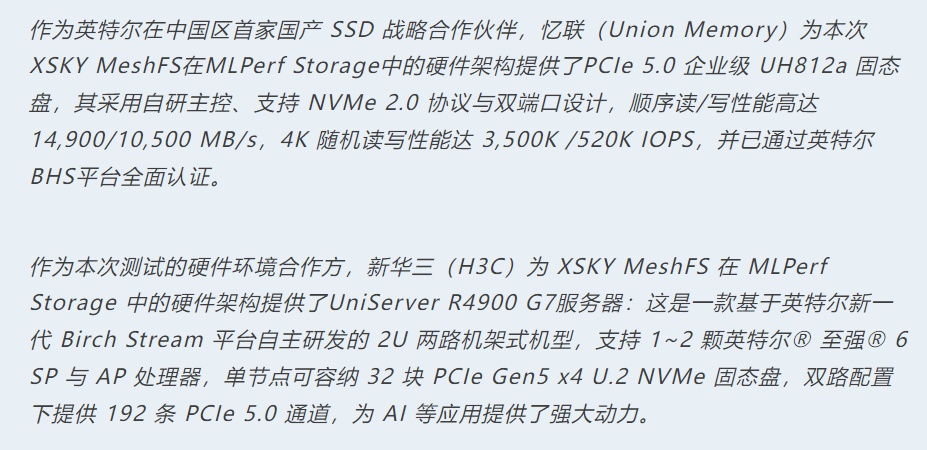
这一成果源于XSKY与英特尔开展的深度合作,MeshFS引入至强® 6 处理器作为核心算力引擎,借助其在算力和带宽上的优势,并结合自身创新的Shared-Everything 全共享架构,有效应对AI场景中存储系统面临的持续大带宽供给、高并发海量小文件处理等方面的挑战。该方案在验证过程中采用了忆联UH812a企业级SSD(固态盘)作为存储介质,完成了全链路压力测试与性能调优。
从结果来看,九项第一分布在 UNet3D 大文件训练、RetinaNet 海量小文件训练、Llama3 405B Checkpoint 读写三大核心场景的”每客户端带宽”、”单位性能硬件成本”、”容量效率”与”最小节点规模”等关键指标上,在性能与硬件投入效率两个维度上同时登顶。这不仅是一份闪亮的成绩单,更为用户推出了一套可直接复制落地的 AI 存储解决方案。
背景与挑战
一直以来,AI 基础设施的投资重心更多聚焦于算力侧,然而随着大模型规模不断扩张,AI 应用能力持续提升,越来越多的 GPU 集群却需要将大量时间消耗在数据等待上。究其原因,是面向通用场景设计的传统存储系统正在AI场景面临诸多新挑战:
1.训练循环需要不断从存储端读取样本与权重,单次读取量可达数十 TB,存储必须在多客户端并发下保持端到端吞吐不衰减;
2.真实训练样本常被切分为成千上万个小文件,这造成了海量的小文件并发和元数据处理压力;
3.Checkpoint 写入量级动辄达数百 GB 至数 TB,故障恢复时还要快速读回,对读写双向能力提出极致要求。
作为存储领域的领先者,XSKY通过新一代高性能全闪存并行文件系统MeshFS的推出,为AI 大模型训练、推理等场景量身定制专属的AI存储系统,在持续保障海量数据供应和海量小文件处理之余,高效完成 Checkpoint 双向读写,同时还能把单位性能成本压到更低。目前,MeshFS的不俗实力已在MLPerf Storage的初次登场中获得证明,其在并行文件存储赛道一举拿下九项第一,全面领跑 AI 存储性能榜单。
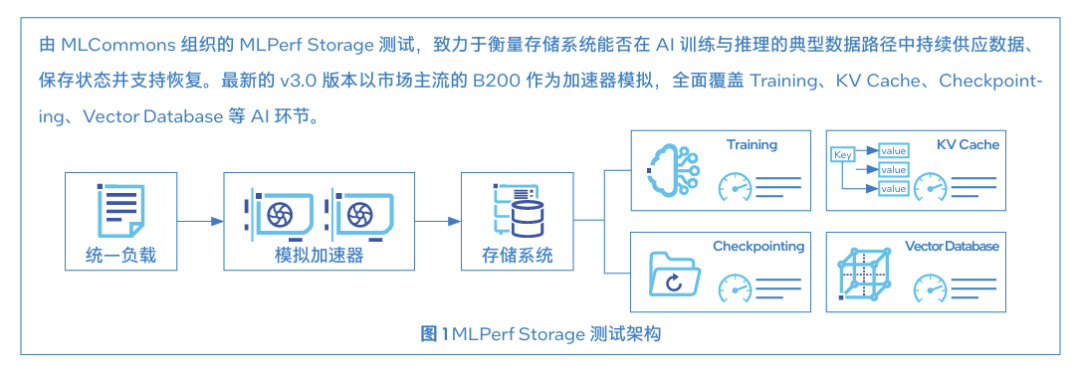
由MLCommons组织的MLPerf Storage测试,致力于衡量存储系统能否在 AI 训练与推理的典型数据路径中持续供应数据、保存状态并支持恢复。最新的 v3.0 版本以市场主流的 B200 作为加速器模拟,全面覆盖Training、KV Cache、Checkpointing、Vector Database等AI环节。
XSKY MeshFS平台与测试方案
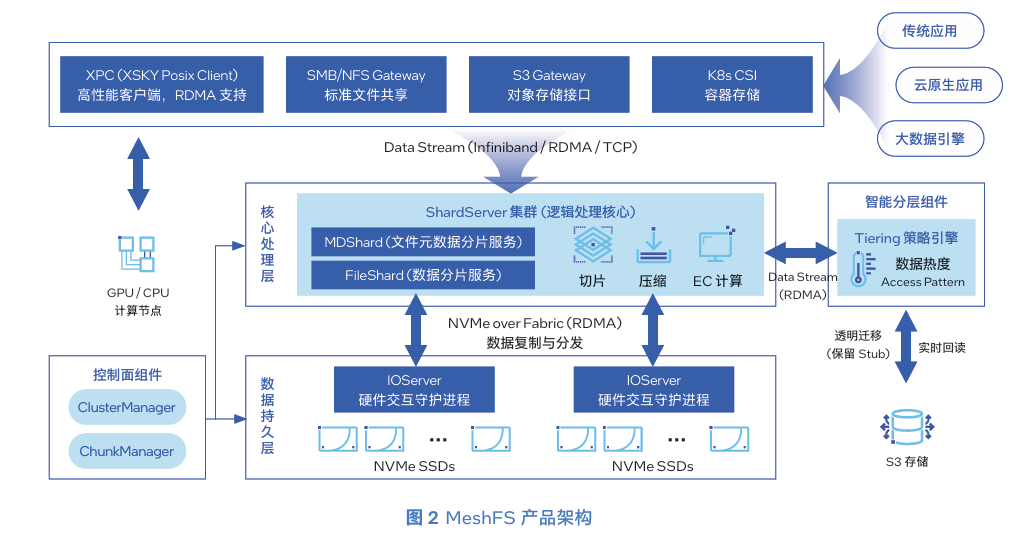
作为 XSKY 的高性能全闪存并行文件系统,MeshFS 专为 AI 大模型训练、推理及大规模数据预处理场景而设计。其基于自研的 Shared-Everything 全闪架构,配合分布式元数据引擎等核心技术,不仅能充分利用 NVMe 与 RDMA(Remote Direct Memory Access,远程直接内存访问)硬件能力,提供微秒级 I/O 延迟,更能做到 TB/s 级聚合带宽与节点级线性扩展能力。平台同时具备故障秒级切换能力,容量与性能可随节点线性扩展,适配不同业务阶段的需求。
在核心技术层面,MeshFS 采用全用户态并行架构,客户端与服务端均绕过内核数据路径,大块直接 I/O 写入,从应用内存到存储介质全链路仅一次内存拷贝,将微秒级硬件能力端到端交付给应用。其 MDShard 分布式元数据引擎采用分片化架构,整系统可支撑千亿级文件规模,有效破解 AI 海量小文件场景的元数据瓶颈;FlexPath™ 智能网络引擎实现用户态多网口聚合、RDMA/TCP 协议自适应切换与毫秒级链路故障切换,并通过”一跳直读”让客户端直接从存储节点读取数据,较传统并行文件系统减少 50% 以上的读写开销。
同时,MeshFS 原生支持 POSIX、NFS、SMB、S3 全协议互通,一份数据可在数据清洗、模型训练、归档管理全流程中零拷贝流动,并通过透明冷热分层将冷数据自动下沉至低成本对象存储,实现”全闪存性能 + 对象存储成本”的最优组合。
● 三节点MLPerf Storage硬件架构
在MLPerf Storage中,XSKY MeshFS使用一套三节点 EC 4+2:1配置的硬件架构来覆盖全部测试场景。如图3所示,其由 3 个同构存储节点与 9 台客户端组成,经 400 Gb/s RoCE (RDMA over Converged Ethernet,基于融合以太网的 RDMA)交换机实现互联。
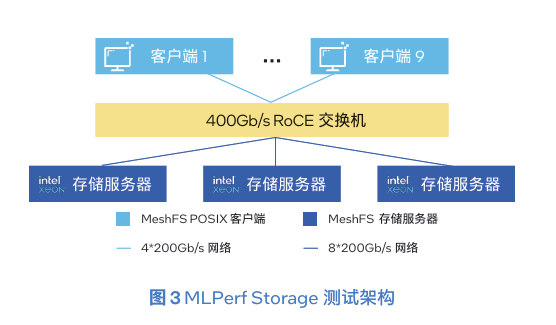
每个存储节点(H3C UniServer R4900 G7服务器)都配置了双路英特尔® 至强® 6530P 处理器、512 GB 内存和 4 个 200*2 Gb/s ConnectX-7 网卡。三节点共使用 48 块 7.68 TB 忆联 UH812a TLC SSD;集群采用 EC 4+2:1 数据保护,可提供 223.5 TiB 受保护可用容量。客户端分三组(每组 3 台),分别搭载至强® 6530P等处理器,通过 POSIX 客户端和 RDMA 网络访问存储。
值得强调的是,从模型训练到 Checkpoint,XSKY MeshFS以一套贴近真实生产环境的硬件架构就跑遍MLPerf Storage全场,没有为任何单项测试更换或追加硬件。这意味着这一架构本质上是提供了一份可直接复制落地的 AI 存储方案。用户无需为不同业务分别规划资源,一套架构即可支撑全流程 AI 业务,令整体成本更为可控。
至强®6平台强力支撑三大测试场景
作为XSKY MeshFS的核心算力基座,至强® 6530P 处理器为其提供了从算力到带宽的一系列有效支撑。
1.强劲算力:处理器提供的强劲算力,让MeshFS有效应对更多AI场景中的实战需求。例如海量小文件归并、元数据检索、小 I/O 调度与 RDMA 协议处理都需要消耗大量CPU算力,至强® 6 处理器的高核密度,提供了充足的并行处理能力与单核响应速度,让这些开销能被充分并行消化,而不是与其它核心业务处理争抢资源;
2.更优带宽:处理器提供了88 条 PCIe 5.0 通道,双路配置下可达 176 条,这个数量配合对等的RDMA网卡,双路处理器理论可直接支持 32 盘 PCIe x4 U.2 或 E3.S NVMe SSD 直连,而不必引入额外的 PCIe 交换层,这些交换层既增加硬件成本,也会引入额外时延。本次MLPerf Storage中的硬件架构正是采用了 PCIe 5.0 原生直连方式,每节点挂载 16 块忆联 UH812a固态盘,无转接损耗;
3.更强网络支持:处理器支持400GbE / 双端口 200GbE 等高性能 RDMA 网卡跑满物理线速,消除网络瓶颈;
4.超大末端缓存:处理器配备了惊人的超大末级缓存(高达144MB L3 缓存),并结合英特尔® DDIO (英特尔® Data Direct I/O)技术,让超高速数据包直达缓存,降低因缓存失效带来的读写延迟;
5.数据防护:MeshFS通过EC 4+2:1 提供强冗余(即把数据切成 4 个数据块 + 2 个校验块,任意 2 块损坏都能从剩余块重建),但这涉及大量的编码以及解码/重建任务,需要大量的CPU 算力作为支撑。至强® 6 平台把 EC 编解码压到指令层,调用英特尔® ISA-L (Intel® Intelligent Storage Acceleration Library,英特尔® 智能存储加速库),让MeshFS能充分利用至强® 6 的向量指令与多核并行完成纠删码运算,编解码开销被显著摊薄,CPU 得以专注处理核心业务,数据重构与磁盘重建耗时同步缩短。
实战:MLPerf Storage九项第一
在MLPerf Storage的 Training · UNet3D、Training · RetinaNet 与 Checkpoint-405B 三个场景,以及整体硬件投入中,XSKY MeshFS 方案共取得九项第一。
● Training • UNet3D,大文件训练读取
Training · UNet3D中,MeshFS主要应对的是约 34 TB 的大文件顺序读取负载,用于考察存储能否持续、稳定地满足训练端读取大文件的需求。测试结果如图4所示,MeshFS 每客户端带宽达 67.73 GiB/s,同时每 GiB/s 硬件成本仅 1,053 美元,均位列第一。落到业务侧,这意味着单集群可以为更大规模的 GPU 集群提供稳定数据供应,而同样的预算可以支撑更大的训练规模。
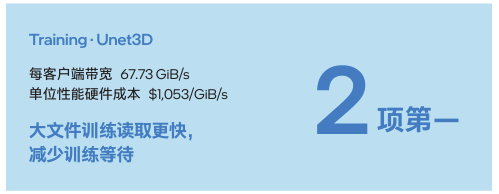
图4 Training · UNet3D 2项第一
● Training • RetinaNet,海量小文件训练
海量小文件场景是最能体现AI存储实力的场景,MLPerf Storage 中的RetinaNet 测试模拟了 675 个 B200 训练 I/O 负载,其包含 7,540 万个、平均约 315 KiB 的小文件。高并发会同时对元数据处理与小 I/O 通路造成巨大压力,本项测试可比口径内仅有4家厂商交卷,可见难度之大。
MeshFS 通过MDShard对元数据进行管理,定位后由数据节点一跳直读返数,从而提供了更短、更快的处理路径。测试结果表明,MeshFS 训练吞吐达 96.13 GiB/s、每客户端带宽 10.68 GiB/s、每 GiB/s 硬件成本 4,163 美元,三项指标全部位列第一,充分验证了 MeshFS在元数据密集与海量小文件高并发场景下的架构优势。
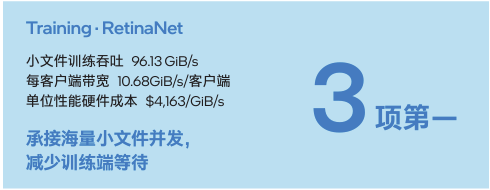
图5 Training · RetinaNet 3项第一
● Llama3 405B,Checkpoint读写
大模型训练中,Checkpoint 直接影响训练连续性与容错能力,既要定期写入保存状态,也要在故障恢复时快速读回。Llama3 405B 单次检查点文件大小达 5,292 GB,对存储读写双向能力要求极高。
MeshFS 在该场景下表现全面,读取每客户端带宽达 47.49 GiB/s(位列第一)、每 GiB/s 硬件成本 1,053 美元(位列第一);写入每客户端带宽也达 13.34 GiB/s,可充分缩短大模型检查点的保存与恢复时间,保障训练连续性。
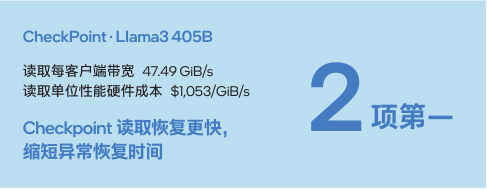
图6 Checkpoint读写2项第一
● 整体硬件投入
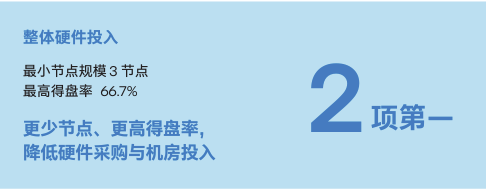
除上述指标外,MeshFS 在容量效率(66.7%,有数据保护组)与被测存储节点数(3 个,全场最少)两项上也获得并列第一。三节点 + EC 4+2:1的配置意味着在有数据保护组中,XSKY MeshFS方案能让AI 存储的建设门槛从整机柜规划降到三台服务器,可显著降低企业构建 AI 存储的起步成本与运维复杂度。
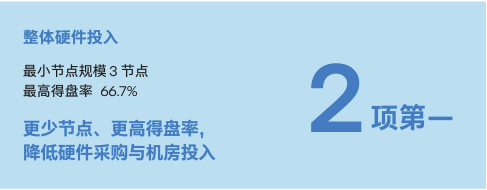
图7 整体硬件投入2项第一
● MeshFS成本评估
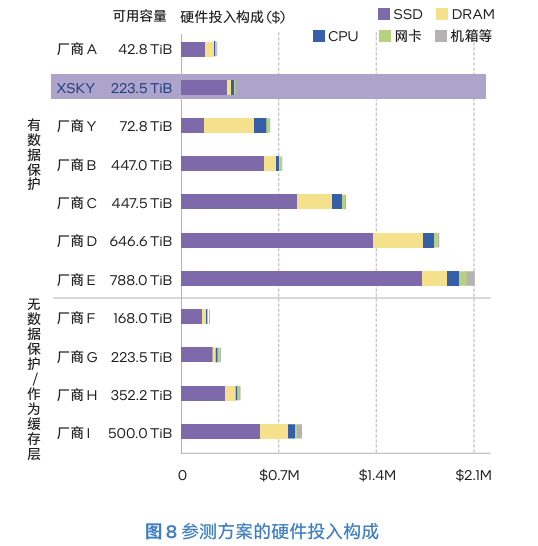
在当前存储成本高企的背景下,成本和性能的平衡也正成为用户选型时的考虑重点,而XSKY MeshFS在本次MLPerf Storage 中体现出的性价比让人眼前一亮。如图8所示,XSKY 三节点集群硬件总投入约 40 万美元,在有数据保护组中作为基准(1.00×)的话,在同口径方案中,有 5 个方案高于该基准,分别是基准的 1.60 倍、1.82 倍、2.97 倍、4.66 倍与 5.28 倍,投入最高的方案是 MeshFS 的5 倍以上。
同时,相比依赖大量 DRAM 缓存、推高 TCO 且存在性能断崖风险的方案,XSKY MeshFS 通过数据直接落盘和 EC 4+2:1(66.7% 容量效率)设计,以更少硬件实现了更高带宽和更可预期的长期成本优势。
总结与展望
MLPerf Storage的测试结果表明,英特尔® 至强® 6 处理器的优势与 XSKY MeshFS 的架构创新形成了有效协同。二者叠加,让一套三节点硬件实现了全负载无短板、性能与成本双重领先。
面向未来,英特尔还将与 XSKY 围绕更多 AI 训练与推理场景深化合作,包括引入新一代至强® 处理器、更高带宽网络与高密 NVMe 等硬件,优化并行读写、海量小文件、Checkpoint 与 KV Cache 四类负载,提升重删压缩效率、降低存储成本;同时持续探索面向 AI ,尤其是 Agentic AI 的存储最佳实践,以至强® 处理器满足智算任务高性能、高扩展存储需求,并通过软硬件的协同优化,让XSKY MeshFS 平台能力最大化,助用户实现稳定可靠的高性能部署,更好地释放数据核心价值。