过去,企业级存储的性能与容量提升,更多伴随介质、接口和硬件迭代逐步发生。AI时代来了,大模型训练、推理和Agent应用正在推动存储性能与容量需求呈几何级增长,也对分布式存储的底层架构和技术能力提出了更高要求。
面向这一变化,新华三新一代分布式存储X20000从底层架构、硬件形态、多协议融合、推理加速等方面展开优化,旨在随智而动,释放分布式存储潜能。
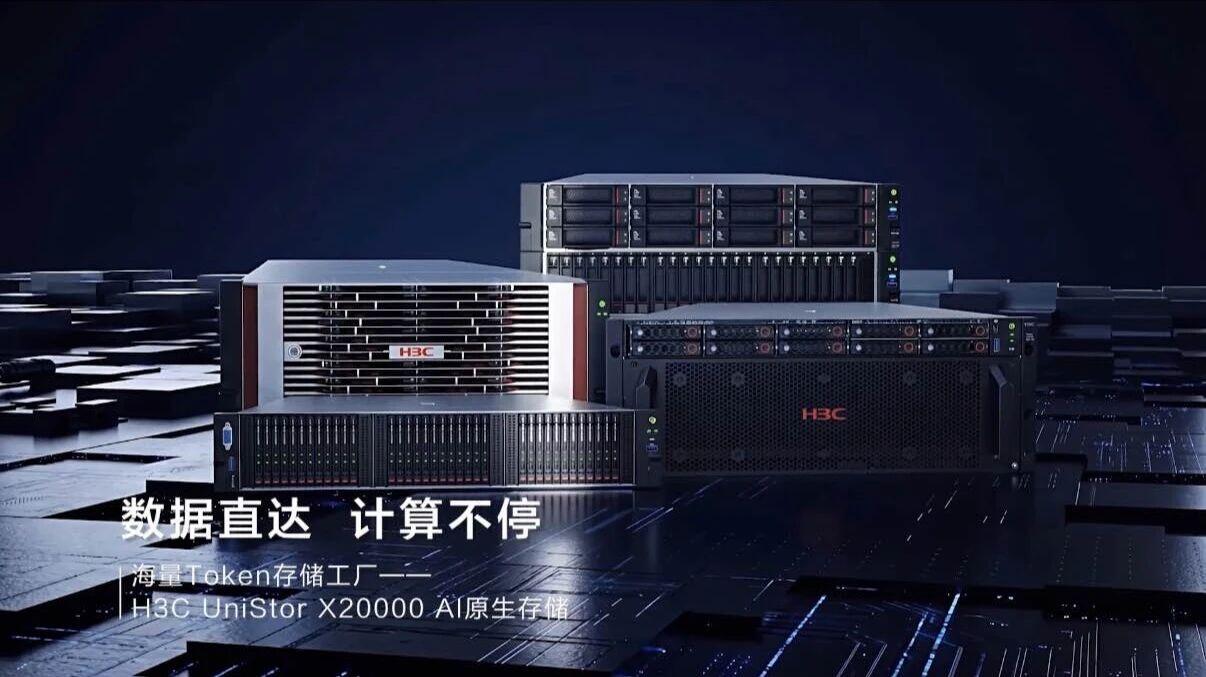
在底层架构层面,新华三已经完成新一代分布式存储核心引擎的自主研发,实现底层代码与技术架构的自主掌控。在此基础上,新华三将持续深化底层技术优化,获得更细致的优化空间和更高的性能上限,进一步巩固新华三在分布式存储领域的领导者地位。
AI重新激活分布式存储
当前的AI技术趋势重新激活了分布式存储。云时代已经证明,集中式与分布式存储并非简单替代:前者仍承载数据库、核心交易和虚拟化等稳态业务,后者则更适合海量非结构化数据的横向扩展。
AI的出现进一步改变了两者的边界。过去,分布式存储更强调存得多、易扩展。进入智算场景后,它还必须为多GPU集群提供高吞吐、低时延的数据供给。存储不仅要通过NVMe释放全闪性能,再加上RoCE降低数据跨网络传输的时延与处理开销,两者结合,形成端到端的数据通路。
基于差异化业务负载需求,新华三 X20000 系列提供多款硬件机型,不简单以冷热数据划分全闪、混闪设备,而是依托统一底层架构,从性能、容量、成本、部署规模四大维度匹配不同业务:
X20836:2U 36 盘 E3.S NVMe 全闪架构,主打数据集读取、大模型训练、高性能文件访问等高负载热数据场景;
X20360:4U 60 盘大容量 HDD 机型,支持 NVMe 硬件加速,平衡海量原始数据存储与高频访问需求。
因此,分布式存储的设计重点并非简单增加硬盘盘位,要围绕模型训练、在线推理、数据服务等多元负载,在存储密度、硬件性能、系统稳定性之间实现平衡。
X20000面向智算和通算两类场景。在智算场景中,重点承载训练数据集、模型文件、Checkpoint和推理所需数据,以及知识库文档、图片、音视频等海量非结构化数据;在通算场景中,满足多样化业务的数据存储与访问需求。
智算虽然追求极致性能,但主要围绕GPU和大模型训推,场景边界相对集中;通算覆盖数据库、交易、虚拟化及众多行业应用,组合更加复杂。因此,新华三的策略是,围绕智算与通算的差异化需求,持续优化性能、扩展性和协议能力,为两类场景提供相适配的存储支撑。
从峰值性能转向复杂负载适配
在大规模智算集群中,单一负载环境下,跑峰值性能不是最难得的问题。真正的挑战是模型、算法和数据类型持续变化,大文件、小文件、读写任务及Checkpoint相互叠加。数据导入、清洗和向GPU持续供数,甚至可能比模型计算更早形成瓶颈。存储厂商无法穷尽所有组合,因此,真实生产环境更考验复杂负载下的稳定承载能力。
复杂性还体现在数据访问方式上。AI数据需要在训练、推理、知识检索和数据分析等环节之间流动,而不同应用采用的协议并不相同:训练可能依赖文件接口,云原生应用和数据湖更习惯对象协议,大数据平台则可能继续使用HDFS。
为此,X20000强调多存储协议融合,在统一数据底座上提供块、文件、对象和HDFS等访问方式,使不同应用能够通过相应接口访问数据,减少因协议割裂带来的数据复制和迁移。标准协议解决的是“能否访问”,自研软件与专用优化则进一步解决高性能场景下“能否跑快”的问题。
用XCache回应推理数据路径重构
推理正在更直接地改变存储产品的定义。长上下文、多轮对话和Agent应用持续扩大KV Cache规模,仅依赖GPU显存和主机内存,容量与成本都面临压力。
在AI推理中,性能也不只体现为每秒能够生成多少Token。用户发出请求后,多久看到第一个结果,取决于首Token延迟,开始输出后是否流畅,则与后续Token间延迟有关。在智能客服、实时Agent和金融分析等时延敏感场景中,即使是毫秒级差异,也可能影响交互体验与决策效率。
X20000重点打造的推理加速引擎XCache,响应了这一变化。其核心思路是“以存代算”——可以将KV数据高速卸载到X20000,缓解GPU显存压力,并提升长上下文和高并发场景下的推理效率。
根据新华三公布的测试数据,在相应测试条件下,KV数据卸载至X20000后,首Token延迟可降低90%,相关推理性能最高优化10倍。
最后
AI正在改变整个基础设施的协同方式。随着存储介质由SAS向NVMe演进,400GbE等高速以太网逐渐普及,RoCE也成为AI集群重要的RDMA互联选择。存储性能由此不再只取决于介质本身,还取决于NVMe存储与RoCE网络能否形成协同。
这一变化与新华三既有的网络能力形成了衔接。早在2021年的SeerFabric智能无损数据中心方案阶段,新华三就开始探索RoCE在存储场景中的调优。对于X20000,其重点转向RoCE与NVMe的联合优化,降低网络传输和协议处理开销,更高效地将数据传输到GPU集群。
在AI系统中,单纯提高存储介质性能并不足以减少GPU等待,只有NVMe介质、RoCE网络、软件栈相配合,存储才能真正转化为计算侧可用的数据供给能力。
最后,“随智而动,释放存储潜能”,既是X20000面向智算与通算的多样化需求,持续提升性能、复杂负载适配与系统协同能力的产品路径,也体现了新华三向更深层基础技术能力迈进的决心,值得期待。