“AI从算力到最后能够服务产业,中间是一个非常长的链条。真正能够把云、边、端打通的核心,是数据。”
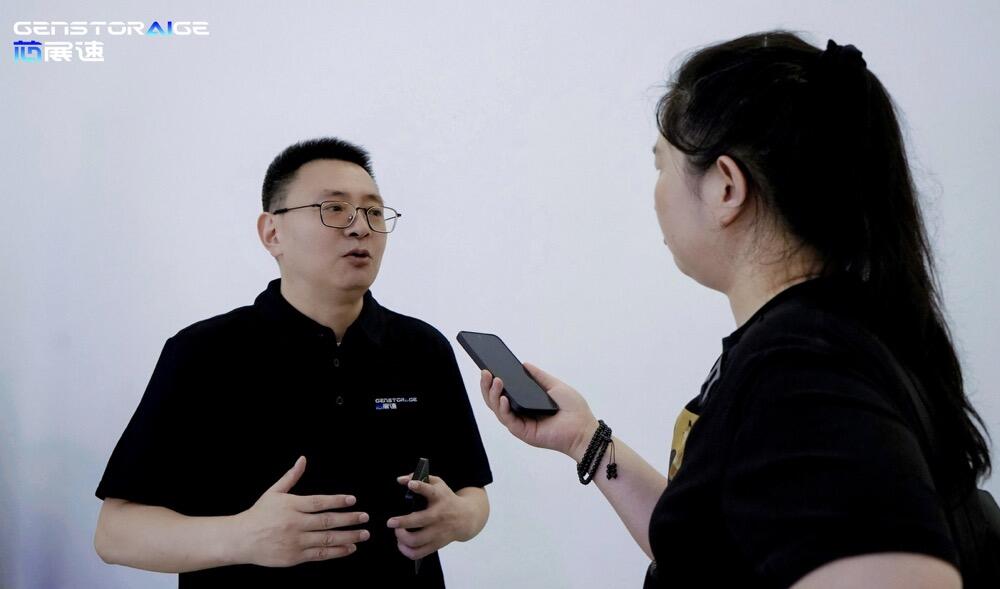
芯展速副总裁金勤勇在接受DOIT采访时这样解释芯展速此次AI战略。当大模型从规模化训练进入推理阶段,这句话有了更具体的指向。
长上下文、高并发带来更多Token,也带来持续增长的KV Cache。有限的HBM如何容纳越来越多的推理数据?当数据无法及时供给GPU,增加的算力能否充分发挥?又如何在性能、容量和成本之间找到新的平衡?
把KV Cache从HBM、DRAM向SSD延伸,已经成为AI存储演进的重要方向。在这一共同趋势下,真正值得关注的是如何针对AI工作负载优化SSD,并进一步让存储与数据调度等能力协同,作用于AI系统效率。
9月17日,芯展速举行AI战略发布会,正式发布面向云-边-端的AI战略布局。芯展速董事长兼CEO孙丹将这一战略概括为八个字——“以存强算,全景覆盖。”
从企业级SSD出发,能力边界向外延伸
芯展速是一家新锐存储企业,成立还不到两年。
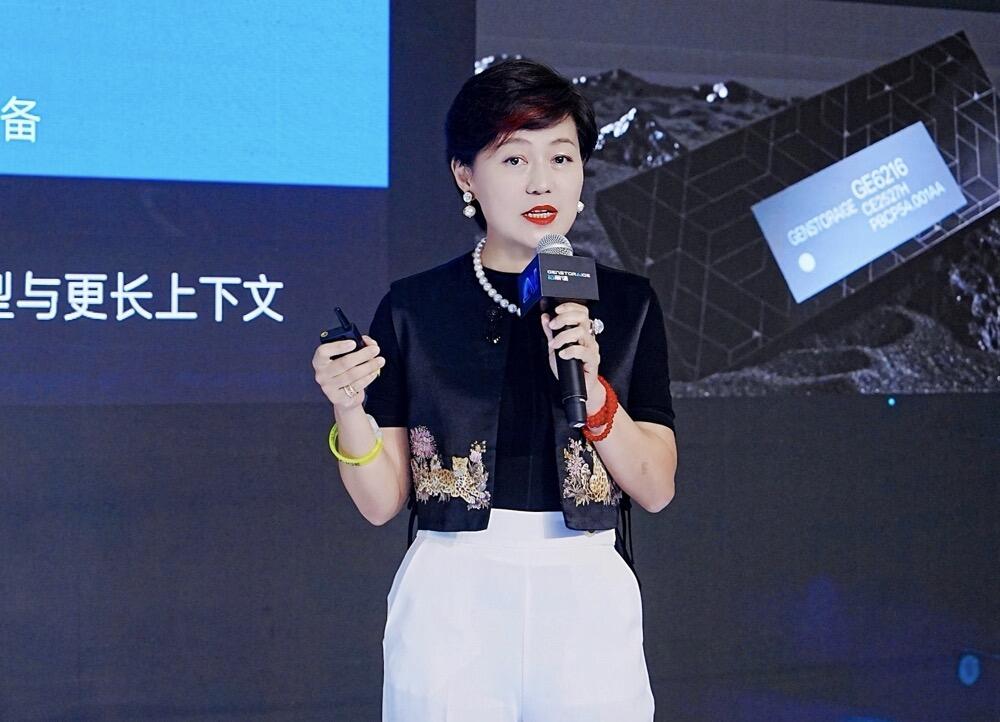
孙丹在发布会上透露,2025年芯展速收入为7000多万元;截至2026年8月,今年收入已经达到22亿元。与业务规模一起扩大的还有团队和产品线。目前芯展速约有200名员工,其中技术和研发人员约110—120人,今年已发货客户达到144家。
芯展速以企业级SSD为重要业务基础,同时将产品延伸至高速连接产品以及AI解决方案。孙丹将其概括为SCS全栈产品布局——从存储介质到信号传输,从硬件加速到系统方案。
围绕“数据”这一主线,芯展速以SSD为产品载体,背后则是介质、主控和固件等能力,并进一步向高速连接、软件和AI解决方案延伸。这也成为理解此次AI战略的起点。
以存强算,“强算”究竟强在哪里?
孙丹将AI推理面临的问题概括为成本墙、内存墙和规模墙。
芯展速希望利用AI SSD为KV Cache提供一个持久的数据层,通过软硬件方案加速数据访问。
存储本身不会替代GPU完成模型计算,“强算”究竟强在哪里?

金勤勇的解释进一步指出,“以存强算”的核心,是通过数据分层、缓存和调度减少GPU等待数据,同时通过KV Cache的保存与复用减少部分重复计算,从而提高已有算力的利用效率。
而当这套逻辑沿着不同AI部署场景展开,便形成了芯展速所说的“全景覆盖”。
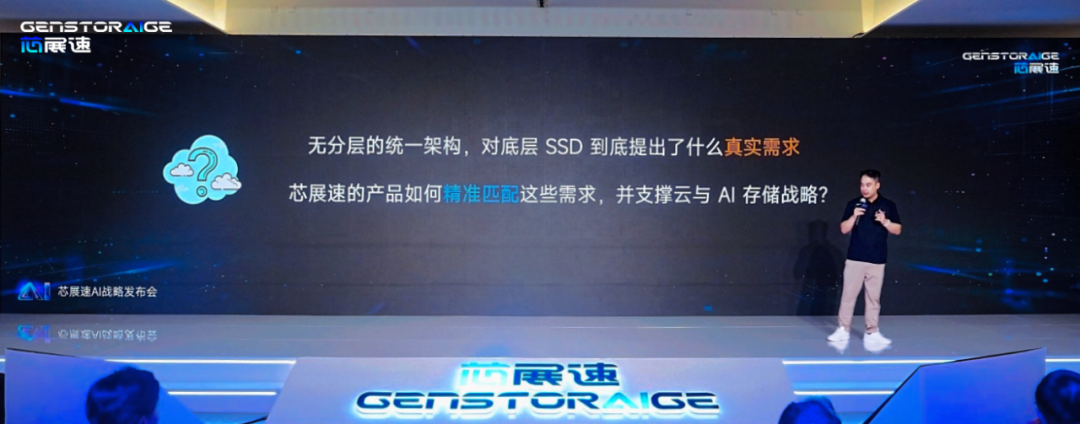
在云端,芯展速副总裁李蓁与VAST Data中国区售前总监刘陈泓共同发布了面向AI存储的全介质栈解决方案。
其思路可以概括为:架构之上无分层,架构之下有讲究。
对于上层AI应用而言,希望面对的是统一的数据平台,而不是感知底层不同介质;但到了基础设施内部,性能、容量、耐久度与成本需求并不相同,仍然需要不同介质各司其职。
芯展速由此提出了SCM+高性能TLC+高密度QLC的组合,其中包括PT200Z AI SSD和MQ系列122.88TB大容量SSD等产品,面向不同的性能、耐久与容量需求。发布会上披露,该方案已获得VAST Data官方认证。
而在传统DRAM与NVMe SSD之间,芯展速还在进一步细分存储层级。
金勤勇在采访中将DRAM与传统NVMe SSD之间的这一层级称为“G2.5”。除了NAND,芯展速还自研构建了类SCM产品,希望在时延、容量和成本之间形成一个中间层。
金勤勇介绍,公司可以根据客户的数据负载,从主控、介质到固件进行针对性调整。KV Cache就是其中一种特殊负载:它既需要高并发I/O,又可能带来高频读写,因此对SSD的性能和耐久提出了与传统通用存储不同的要求。
换句话说,在AI存储分层已经成为行业共同方向之后,芯展速试图进一步回答的是:进入分层之后,SSD本身应该怎样适应AI。
边侧,芯展速发布AI90训推加速引擎,通过KV Cache智能调度和P2P互联,将部分KV Cache从HBM卸载至高性能AI SSD,形成HBM+DRAM+SSD三级存储体系。
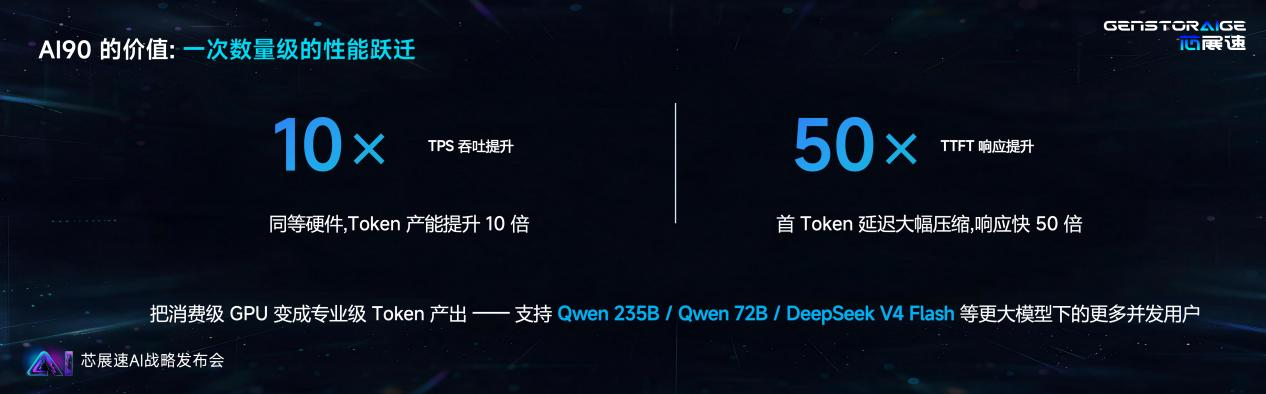
图:AI90 训推加速引擎 Token吞吐提升效果
端侧,芯展速通过AI30将AI能力进一步延伸至本地。AI30与端侧推理引擎Herdsman及混合模型策略结合,可根据任务需求在本地与云端模型之间进行调度。
由此,从云端全介质存储、边侧训推加速到端侧本地AI,芯展速形成了“云—边—端”的AI布局。
Token经济背后,芯展速看到的是“算力平权”
随着AI进入规模化推理阶段,如何降低Token生成成本,同样成为基础设施需要回答的问题。
金勤勇将Token经济背后的核心概括为“算力平权”。
在他看来,Token经济背后更值得关注的是,企业能否以可承受的成本真正获得AI能力。
过去评价企业级SSD,容量、IOPS、带宽、时延、耐久度以及每TB成本都是重要指标;这些指标今天依然重要,但当SSD开始承载KV Cache并参与AI运行时的数据调度,它对系统价值的影响又多了一层——能否减少GPU等待,并通过KV Cache复用减少部分重复计算,以相同的计算资源支撑更多Token生成。
这也让孙丹所说的“以存强算”,与金勤勇所说的“算力平权”连接起来。
前者关注的是存储如何作用于算力效率,后者则进一步将这种效率落到AI的使用成本。
当单位Token背后的计算、内存和存储成本进一步下降,企业部署和使用AI的门槛也有望随之降低。
这或许才是芯展速此次“以存强算,全景覆盖”背后更值得关注的部分。