过去两年,生成式AI与智能体应用快速爆发,数据中心算力的瓶颈正重新回到通用计算节点。海量小模型推理、任务编排、工具调用与状态管理,并不只是依赖GPU并行算力,更离不开CPU对串行逻辑、中断响应、并发调度和内存访问的组织能力。服务器处理器因此再次成为AI基础设施中的关键支点。
在此背景下,AMD于2026年11月在拉斯维加斯举办“AMD In Depth 2026”媒体沟通会。AMD高级副总裁、企业院士及首席架构师Mike Clark系统披露了Zen 6架构的演进方向。
Zen 6 家族核心设计目标
Zen 6的设计目标不仅局限于传统性能提升,还涵盖了AI能力增强、机密计算强化以及全栈灵活解决方案的提供。Zen 6架构面向新一代2纳米制程晶体管带来的设计机遇,在频率、IPC、功耗与芯片面积之间进行精细权衡取舍。
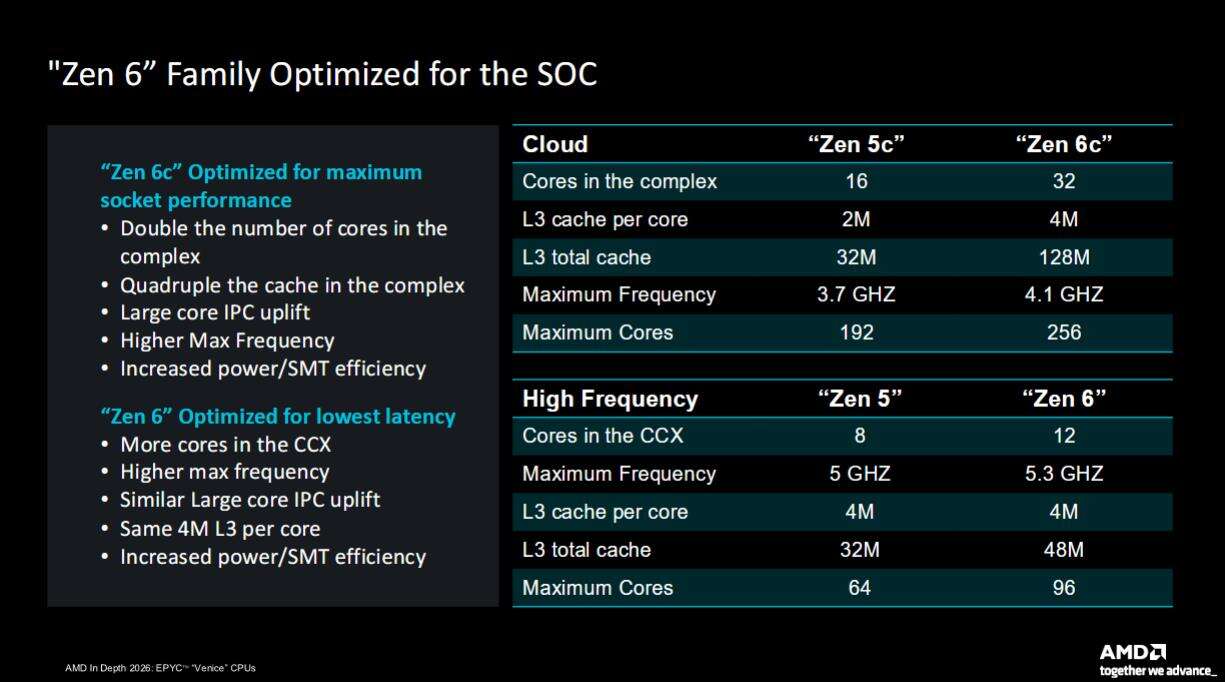
Zen 6家族包含两种核心:面向云端高密度部署的Zen 6c与面向高频场景的Zen 6标准核心。其中,Zen 6c以单复杂模块容纳更多核心、共享更大三级缓存来换取最大吞吐,相比前代complex内核心数从16个翻倍至32个,总L3由32MB增至128MB、每核L3达4MB,最高频率4.1GHz;Zen 6则以CCX内更多核心与5.3GHz的最高频率换取最低延迟。两种核心在指令集层面完全一致,确保软件兼容性。
凭借高频与高密度核心的差异化布局,AMD将以基于Zen 6架构的Venice系列处理器在智能体时代承担灵活计算的关键角色,在兼顾安全性的同时为客户提供卓越性能。
Zen 6c微架构概览
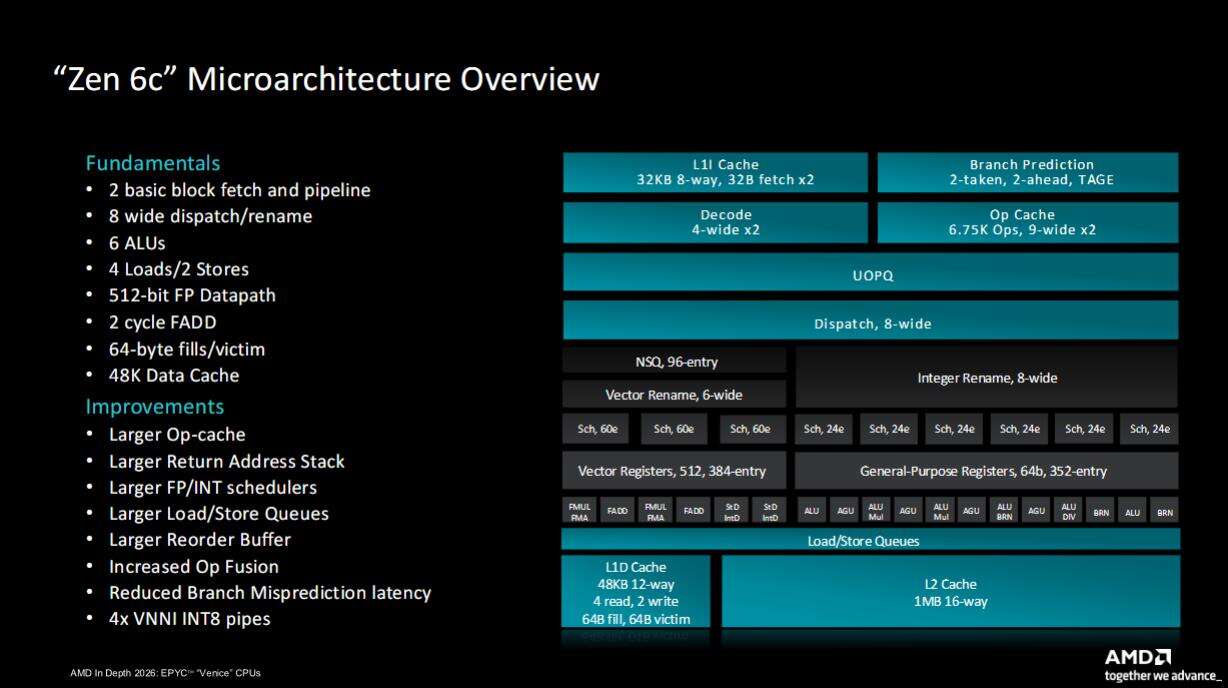
作为高密度版本,Zen 6c将发射与重命名宽度提升至8,执行资源扩展为6个整数ALU、每周期4次加载与两次存储,并配备512位浮点数据通路,浮点加法延迟仅两个周期,访存按64字节粒度进行填充与回填,数据缓存容量达48KB。这些基础参数共同为AI与传统浮点负载提供了一个高能效的算力底座。
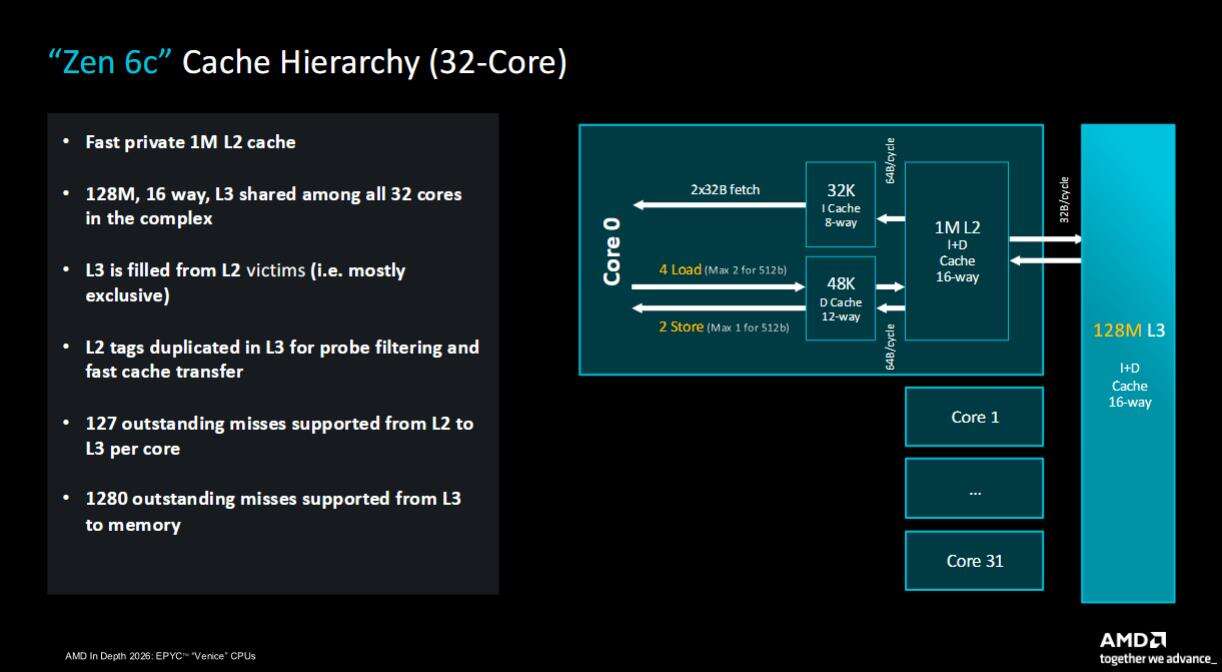
相较上一代,Zen 6c在缓存层级上做了明显放大。每个核心配备1MB、16路的私有L2缓存,complex内32个核心共享128MB、16路的L3;L3由L2的victim填充,基本为独占式结构,L2标签在L3中复制以支持探测过滤和快速缓存迁移。未命中承载能力上,每核从L2到L3支持127个outstanding miss,L3到内存支持1280个。每核前端为2×32B取指、32KB 8路指令缓存,L1数据缓存48KB 12路、4读2写,L2带宽32B/cycle。
可以看出,Zen 6c的思路是把前端吞吐与后端并行度同步抬高,使其在有限频率下仍能取得更高的指令级并行与IPC表现。
分支预测与取指调度优化
前端是决定IPC上限的第一道闸门,Zen 6首先从分支预测与取指入手。AMD对预测表结构进行了优化,将返回地址栈扩大至64条目,并增大了分支预测队列,使预测器每周期可给出两个taken预测、维护最多三个预测窗口,从而在难以预测的负载下降低误判代价,让取指流更快恢复运转。
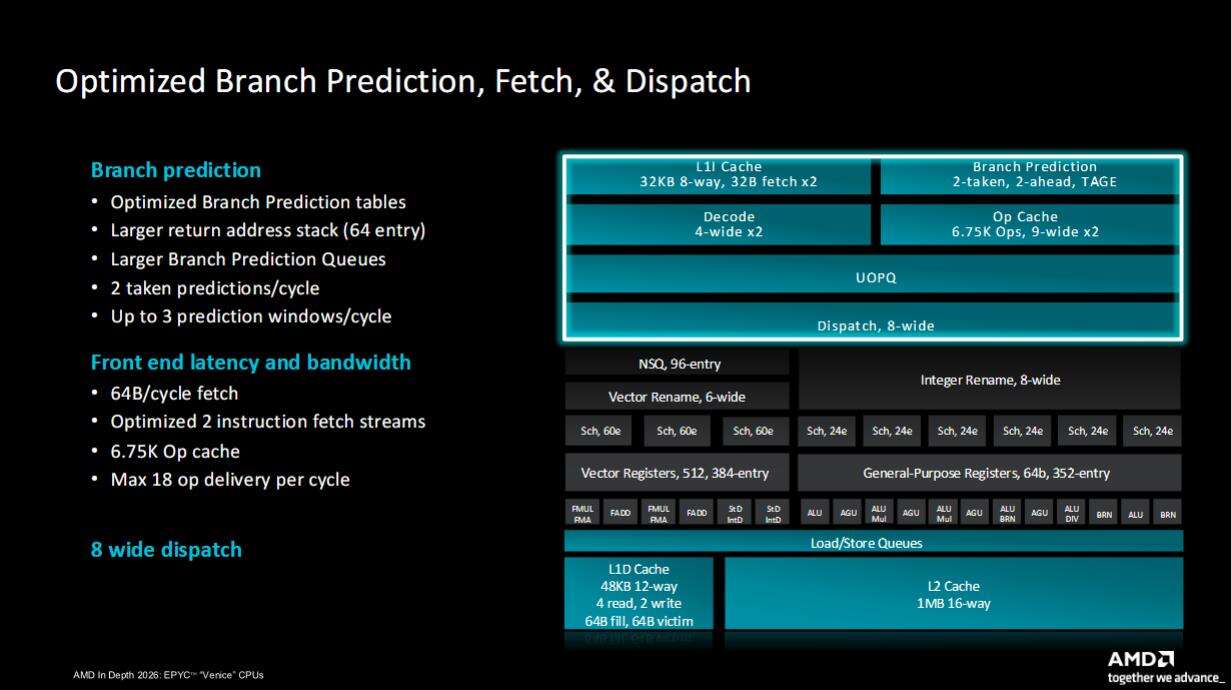
与预测能力相配合,前端在延迟与带宽上同步加宽:每周期取指带宽达64字节,取指流水为两路经过优化的指令流,操作缓存容量为6.75K操作,每周期最多可向下游交付18个操作,配合8宽的重命名与分发,确保后端执行单元不因缺少指令而空转。操作融合的深入应用则进一步压缩进入调度器的指令数量,把有限的调度资源集中到真正需要执行的微操作上,在降低功耗的同时提升整体吞吐效率。
调度执行与数据带宽
前端能否持续输送足量的微操作只是前提,指令能否被高效执行还取决于后端调度与数据带宽的配合。
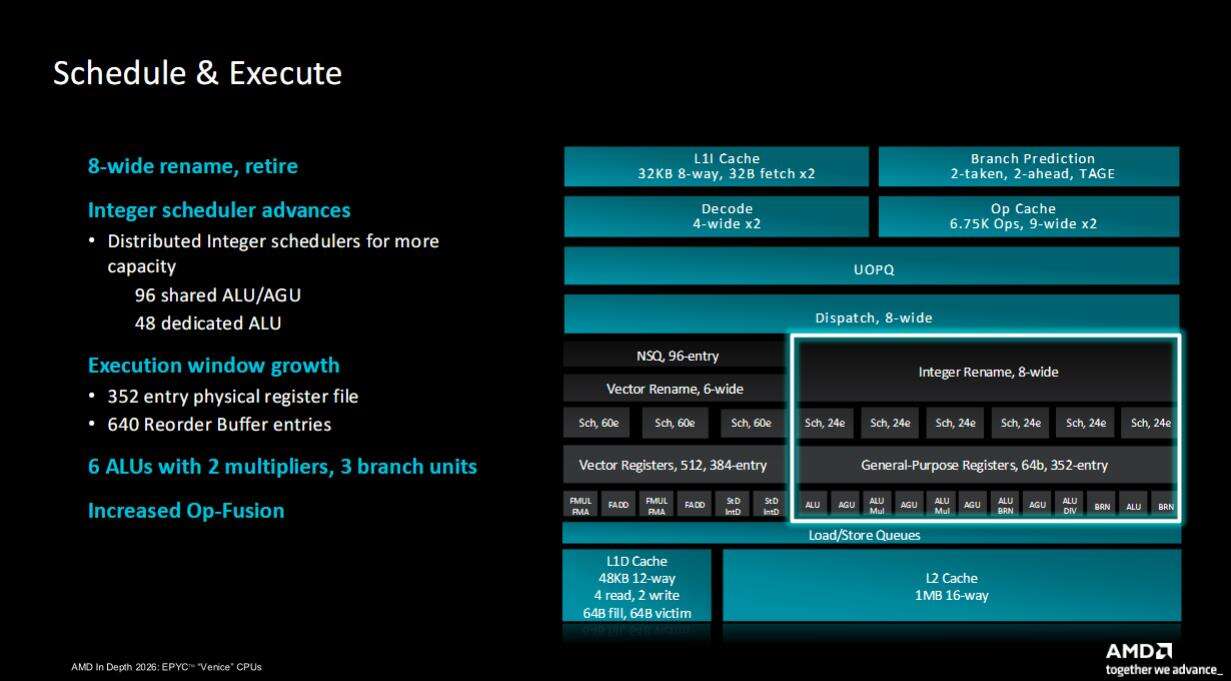
在整数调度执行单元方面,Zen 6的整数重命名与引退(Rename & Retire)阶段已全面拓宽至8条指令,整数调度器采用分布式设计,共享的算术逻辑单元(Arithmetic Logic Unit,ALU)与地址生成单元(Address Generation Unit,AGU)调度器总容量扩展至96个条目,此外还配备了48个专用ALU。后端执行流水线包含6个ALU(内含两个专用乘法器)和3个分支单元。为支撑更深的乱序执行能力,Zen 6的执行窗口大幅增长:通用整数物理寄存器扩展至352个条目,重排序缓冲区(ROB)增至640个条目,向量寄存器为512位宽、拥有384个条目。
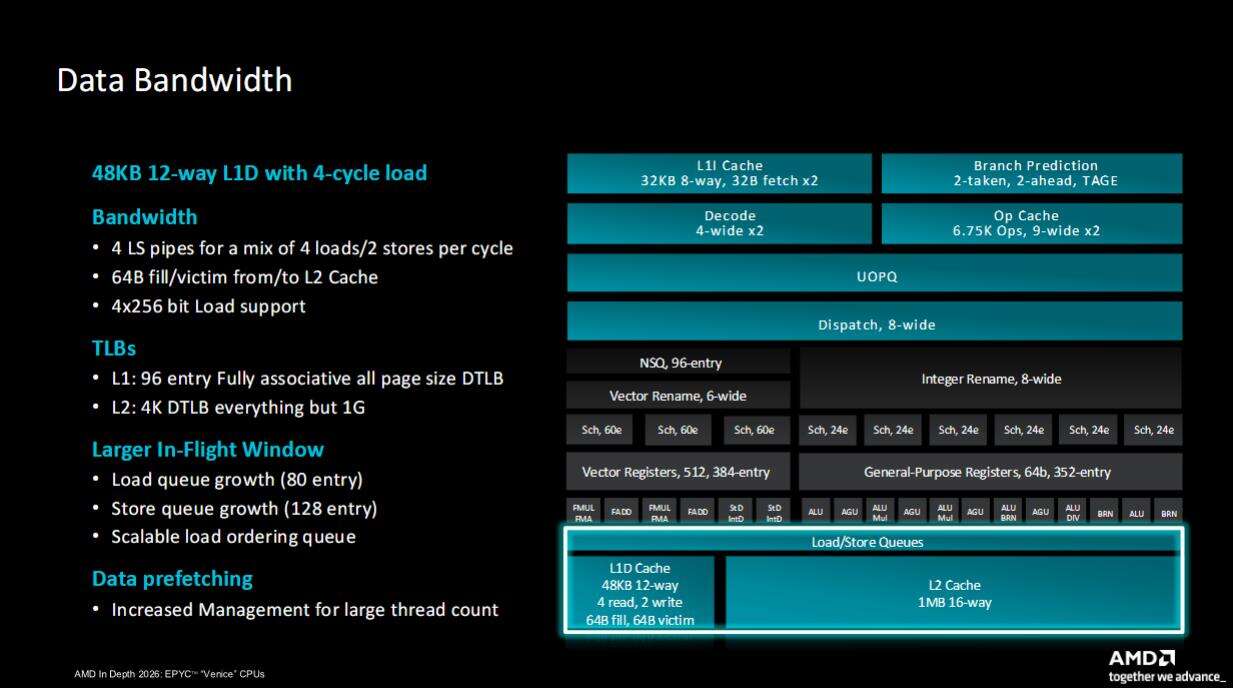
数据带宽方面,Zen 6配备了48KB、12路组相联的L1数据缓存,加载延迟为4个周期;核心配备4条加载/存储流水线,支持每周期4次加载与两次存储的混合吞吐,加载单元还支持4×256位加载以更好地供给浮点单元。TLB方面,L1配备96个全相联的DTLB以支持所有页面大小,L2则配备4K的DTLB(不支持1G大页)。在访存队列上,存储队列已大幅增长至128个条目,加载队列增至80个条目,并引入了可扩展的加载排序队列;L1D与L2 Cache之间则维持64字节的填充与回填速率。
浮点单元与缓存层次
如果说整数与访存路径是通用算力的底盘,那么浮点单元与缓存层次则直接决定AI推理的上限。
Zen 6浮点单元在数据通路宽度上延续512位、保持两条乘法加两条加法的管线配置,但在数据格式与吞吐上显著增强:FP16从仅支持格式转换升级为完整的AVX-512 FP16计算,新增位矩阵乘法BMM指令,VNNI-INT8的执行管线由2条翻倍至4条,而VNNI-INT16与BFLOAT16维持2条不变;浮点加载可处理两个512位或四个256位数据,浮点调度器也由3×32扩展至3×46+,为智能体推理等AI负载提供了更强算力。
缓存层次上,每核拥有独立的1MB私有L2缓存、采用16路组相联设计,L1与L2之间维持64字节的传输粒度。在32核的复杂模块配置下,128MB的三级缓存由全部核心共享、同样为16路,主要由L2回填的数据填充并保持近似独占,同时在L3中保留L2标签副本,用于探测过滤与快速缓存传输。每核从L2到L3可支持127个未完成访问,整个CCX从L3到内存可支持1280个未完成访问,为高并发下的访存带宽提供了保障。
新指令集与服务器性能
架构能力的最终价值,要落到指令集兼容性与实测性能上。
指令集层面,Zen 6新增完整FP16支持,引入更多AVX-VNNI-INT8指令、用于BF16与FP16向FP32转换的AVX-NE-CONVERT、升级为VEX编码的AVX-IFMA以及全新的位矩阵乘法指令。内核与虚拟化方向引入FRED作为全新的中断、异常与系统调用接口,提供页修改日志PML以高效识别客户机脏页(Guest Dirty Pages),并通过PLZA在特权级切换时自动变更服务质量类别。
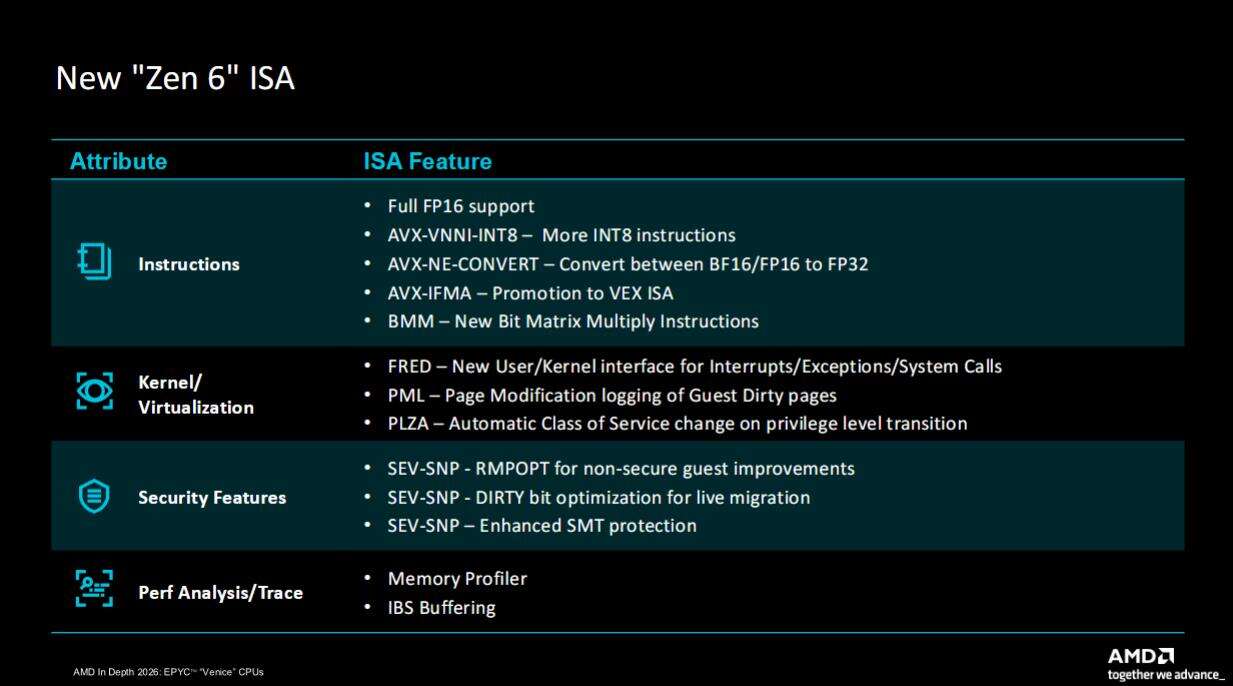
安全方面强化了SEV-SNP,包括面向非安全客户机的RMPOPT、用于热迁移的脏位优化与增强的SMT保护,并加入内存剖析器与IBS缓冲等性能分析能力。
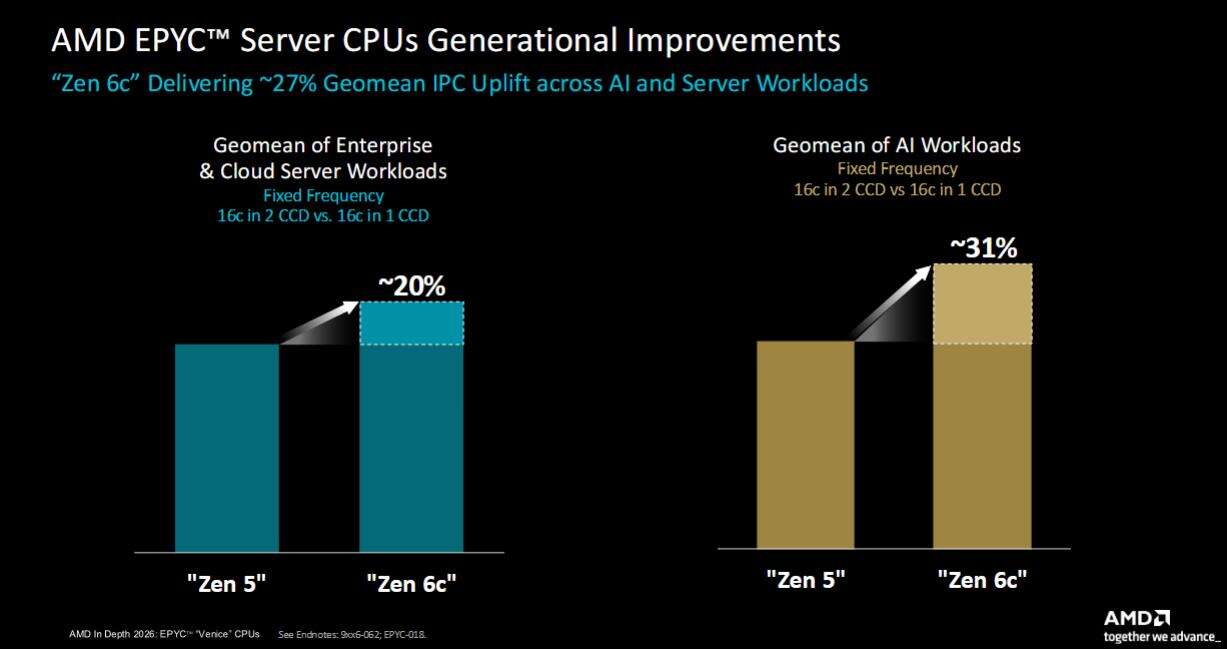
服务器性能上,在固定频率、将16核由两个CCD收敛到1个CCD的对比条件下,Zen 6c相对Zen 5c在企业与云负载的IPC约提升20%,在AI负载约提升31%,二者综合的几何均值提升约27%。
结合Zen 6c面向最大吞吐、Zen 6面向最低延迟的差异化设计,Zen 6家族在智能体计算时代以性能领先、灵活配置与更强的机密计算能力,为新一代数据中心树立起兼顾吞吐、延迟与安全的世界级性能标杆。
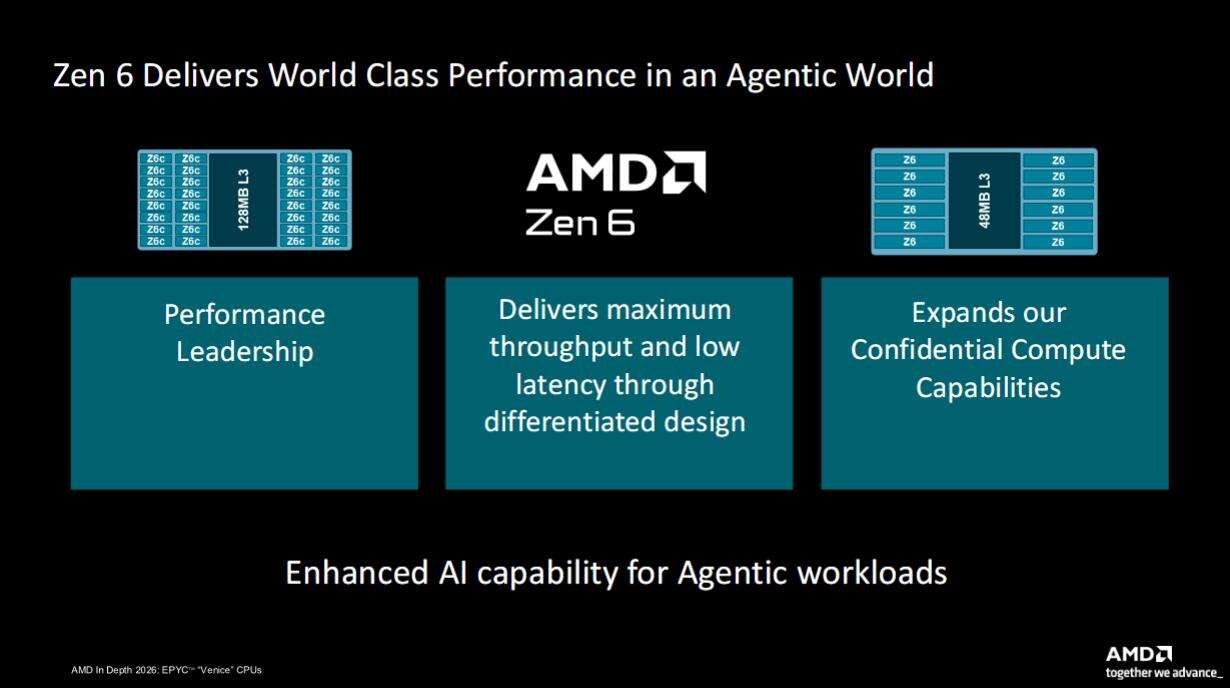
通观整场沟通会,Zen 6并未因制程红利而保守迭代,反而在调度宽度、缓存容量、AI数据通路与机密计算上全面加宽,并以Zen 6c、Zen 6的差异化分工兼顾吞吐与延迟。
Zen 6的落地表明,x86架构在智能体时代仍保有清晰而强劲的技术前景。