随着大模型能力的不断提升,AI从聊天问答走向任务执行,并逐步进入机器人、自动驾驶等物理世界的应用场景。当AI应用越来越复杂,当用AI 的人越来越多,对底层基础设施的要求也大不一样。
一方面,模型训练需要更大规模的算力,如何充分利用不同类型的GPU,提高训练效率,成为关键问题。另一方面,具身智能、多模态模型的发展带来了海量数据,如何完成数据存储、处理和高效供给,同样影响着AI系统的效率。
10月30日,在2026腾讯全球数字生态大会上的算力与云基座专场中,腾讯云集中展示了面向Agent、大模型和具身智能的基础设施技术与产品升级。其中,异构计算和AI存储成为此次专场的重要看点。
从国产GPU的适配优化,到海量训练数据的存储、处理与加速,腾讯云正在通过计算、存储以及网络能力的协同,加速构建面向AI时代的云基础设施底座。
从Agent部署到企业级托管,让AI在云端持续运行
腾讯云副总裁李力在开场演讲中谈到了云计算对于AI的重要性,他认为,像OpenClaw这种部署在个人电脑上的方式,并不代表AI应用的最终形态。
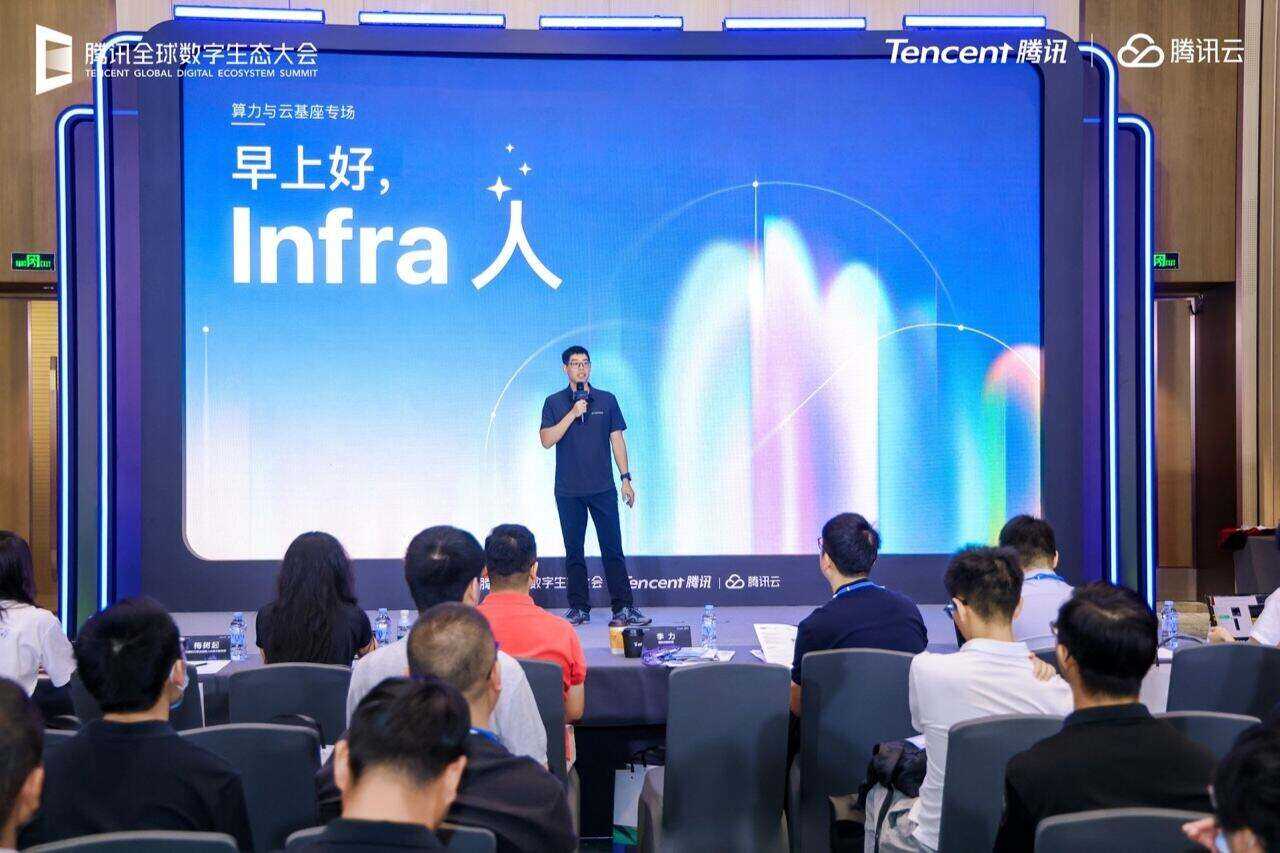
一如早期的网站也曾部署在个人电脑上,但随着互联网的发展,应用会逐渐迁移到云端,AI也会经历类似的过程。未来,企业不需要每个人都在本地部署一套强大的AI系统,而是可以通过云端获得AI能力,把精力集中在自己的业务创新上。
随着Agent从个人工具逐渐进入企业业务系统,腾讯云正在探索如何将Agent的部署、运行、管理变成体系化的云服务。因此,腾讯云将面向Agent的系列云端产品整合为Agent Hosting,进一步完善从个人开发者到企业级应用的产品体系。
比如,Lighthouse提供Agent部署环境,配合Lighthouse Agent让部署变得更轻松,同时,搭配SkillHub来发现、分享和复用常用的能力。如果是需要管理大量Agent 的企业用户,则可以尝试ClawPro来批量分发和管理大量Agent。
事实上,已经有企业用ClawPro产生了实际的业务价值。博商CTO谢俊杰介绍称,博商基于腾讯云ClawPro,将20多年的企业管理咨询经验转化为可供Agent调用的专业技能,并逐步应用到战略管理、销售、生产、财务等场景。
目前,博商约1200名员工中,已有近900人参与AI应用。通过与腾讯云合作,博商还将这套经验推广至500多家企业,覆盖新能源、工业制造、供应链等多个行业。其中,一家新疆企业利用AI辅助招投标,将原本需要4天完成的标书工作缩短至2小时。
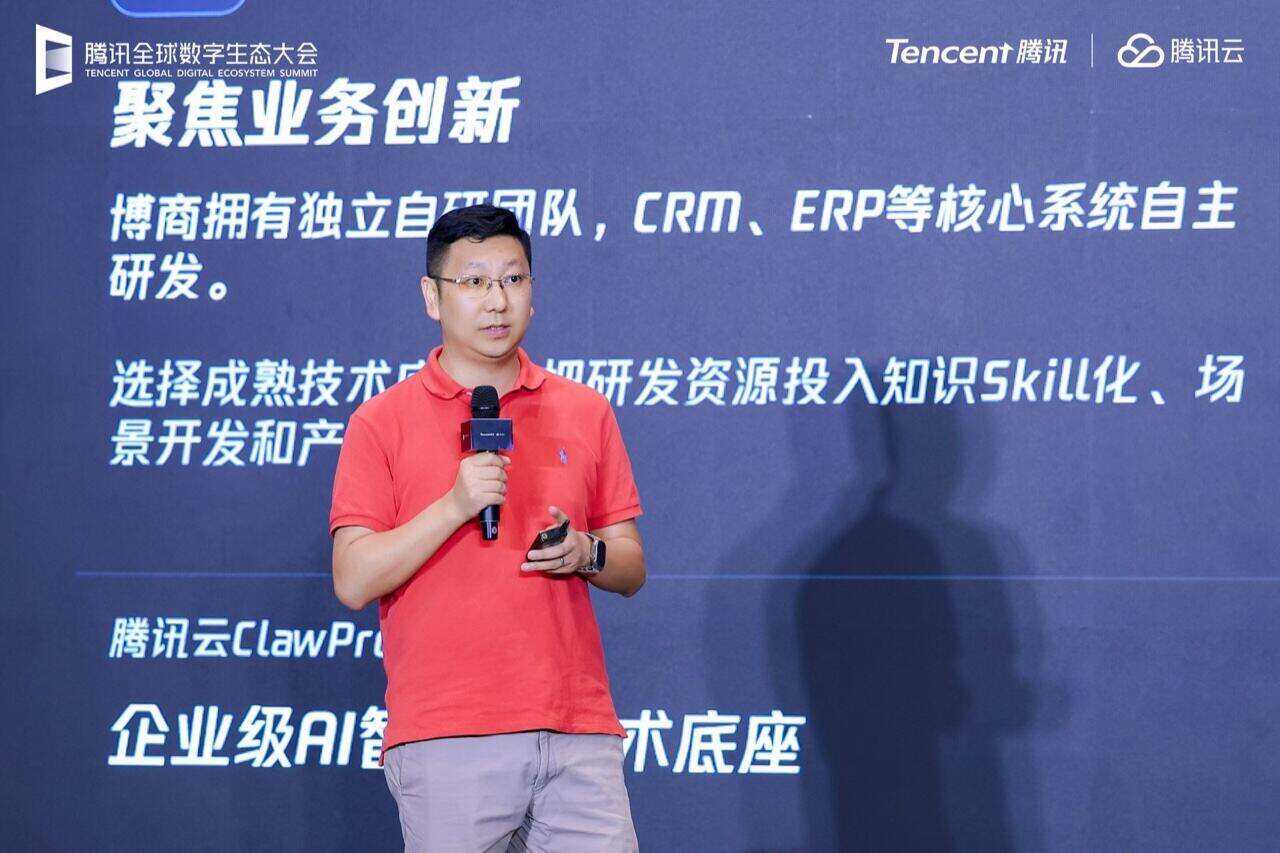
谢俊杰表示,腾讯云负责Agent技术底座的持续升级,博商则发挥自身在企业管理咨询和业务落地方面的优势,帮助客户将专业知识、业务流程和实践经验沉淀为可持续复用的AI能力。
异构算力持续优化,让国产GPU更好地支撑AI训练
如果说Agent Hosting解决的是AI应用如何在云端运行,那么对于大模型和具身智能企业来说,如何提高模型训练效率,则是另一个重要问题。
当前,AI模型训练对算力的需求持续增长,越来越多的企业开始探索不同类型的算力资源。但由于不同GPU在硬件架构、软件生态和算子支持等方面存在差异,使得模型迁移、性能优化和训练稳定性都面临非常大的挑战。
腾讯云异构计算产品副总监黄阳在现场介绍了面向具身智能的数据处理、训练与仿真、推理部署三大算力底座,重点展示了腾讯云在异构算力调度,特别是国产算力适配优化和训练加速方面的技术进展。
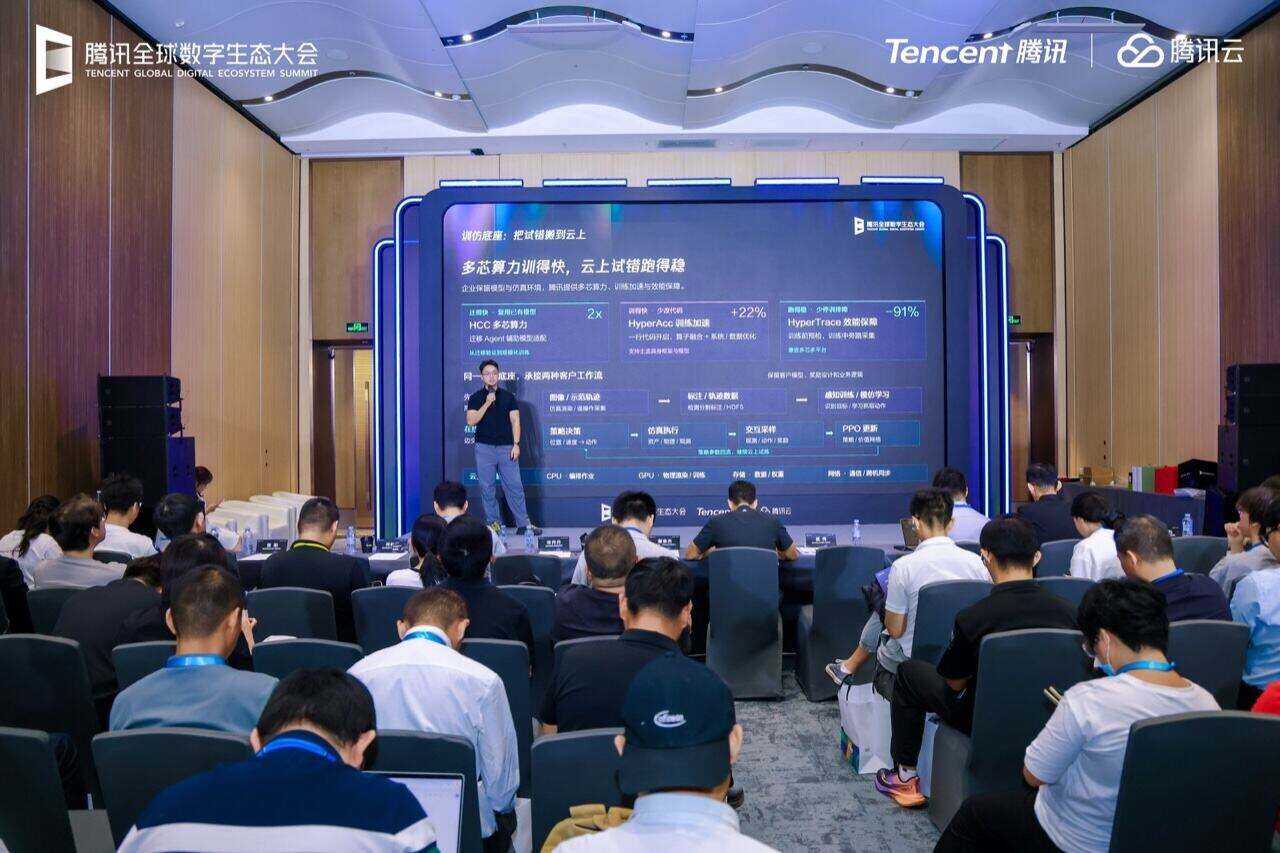
越来越多的用户开始选择利用国产算力进行训推任务。。但不同芯片的软件生态大不相同,腾讯云通过HCC多芯算力支持和AI算子优化Agent,帮助客户降低模型迁移的复杂度。据黄阳介绍,它可以将模型迁移速度提升约2倍。
其次是提高训练效率。腾讯云推出的HyperACC训练加速套件,通过软件层面的优化提升训练性能,甚至能实现一行代码就开启训练加速。在千卡规模国产芯片的实测场景中,HyperACC实现了至少22%的性能提升。
训练规模越大,稳定性就越重要。大规模GPU集群运行过程中,硬件故障、通信异常和性能波动都可能影响训练。腾讯云通过HyperTrace效能保障组件,在训练前进行集群预检,在训练过程中持续采集和监控运行状态,帮助用户更快定位问题。
据黄阳介绍,HyperTrace能够将相关故障的排查时间减少90%以上。对于训练环节来说,更快定位问题就能快速解决问题,继续推进训练进程。这不仅减少宝贵GPU资源的浪费,还可以让模型训练周期更可预测。
某头部具身智能模型团队希望将VLA模型训练任务迁移到国产GPU。腾讯云通过AI算子优化Agent和HyperACC等技术,帮助客户在两周内完成了模型向国产芯片的迁移。在相关模型微调任务中,最终性能相比原方案提升52%以上。
从海量数据存储到训练加速,腾讯云完善AI数据基础设施
算力之外,数据也是影响AI模型训练效率的重要因素。腾讯云存储产品解决方案总监温涛表示,随着算法和算力逐步走向成熟,数据的质量、来源和规模将成为具身智能企业建立差异化竞争优势的重要因素。
温涛在现场介绍了面向具身智能的数据飞轮解决方案。该方案围绕数据采集、处理、交付和模型训练等环节,将对象存储COS、数据万象和GooseFS等产品结合起来,为模型持续迭代提供数据支撑。
据温涛介绍,在相关标杆客户的应用中,腾讯云数据飞轮解决方案可以将数据处理时间缩短35%,GPU利用率提升90%以上,模型训练时间缩短30%以上,整体存储成本降低30%以上。
从整体技术产品架构来看,腾讯云存储部分希望解决三个核心问题:数据如何存得下、如何用得好,以及如何更快地供给模型训练。
首先,海量数据的存储问题。
具身智能模型训练涉及大量不同格式的数据。这些数据需要长期保存,并在不同训练任务之间反复使用。腾讯云以对象存储COS作为统一的数据存储底座,为大规模训练数据提供容量和持久化支持。
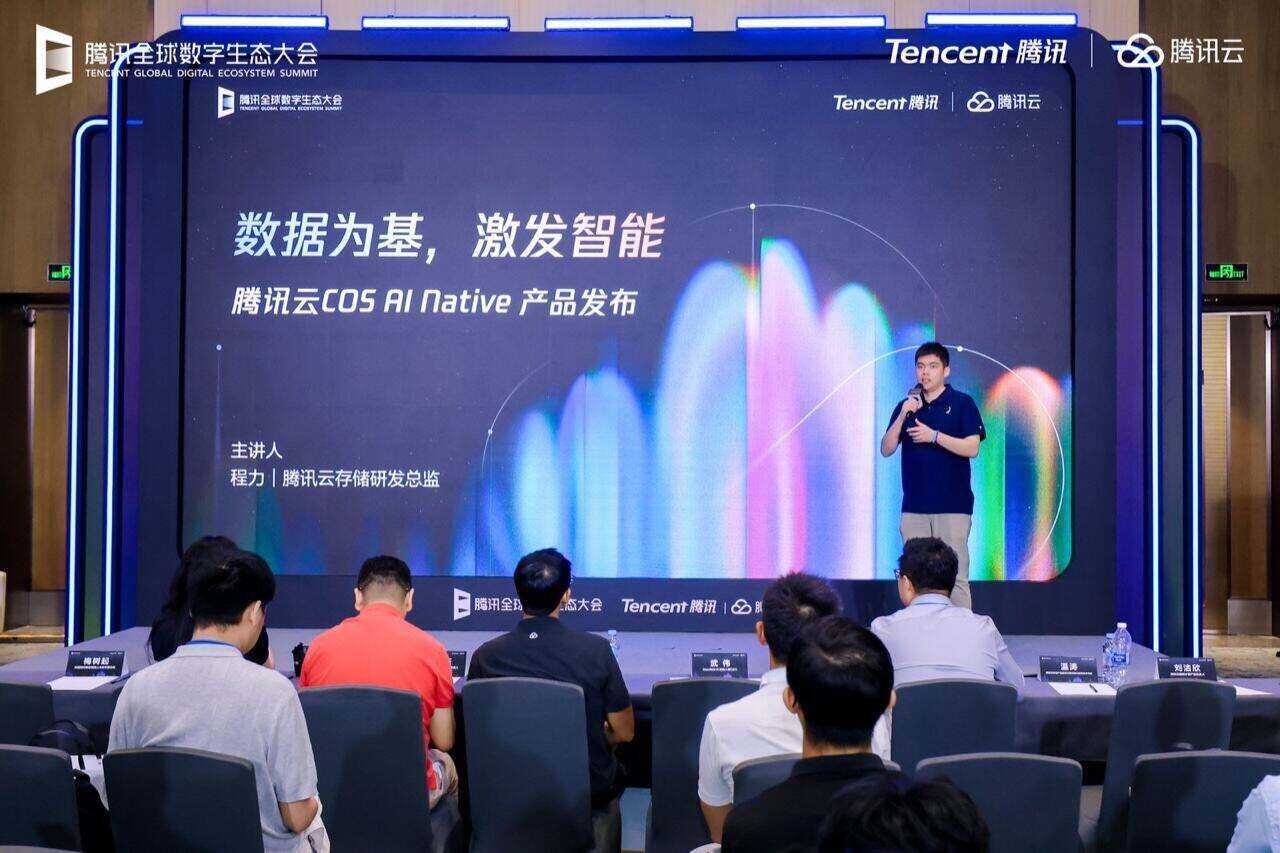
随着数据规模的增长,存储成本也是必须考虑的问题。腾讯云AI存储研发总监程力介绍,面对AI训练、推理和多模态数据需求的增长,以及存储介质价格上涨带来的压力,腾讯云正在通过多种存储介质和冷热数据分层,为客户提供更多选择。
此次腾讯云还介绍了Rapid Bucket、Vector Bucket、Agent Bucket等对象存储能力,分别面向高性能数据访问、多模态检索和Agent数据管理等不同需求,进一步扩展对象存储在AI场景中的应用。
其次,如何让原始数据变成可以用于模型训练的高质量数据。
采集到大量视频只是第一步,这些数据可能存在重复、模糊、等问题,还需要经过质检、拆分、标注和整理,才能形成可用于模型训练的数据集。如果这些工作完全依赖人工,不仅耗费大量时间,也会影响模型迭代速度。
针对这一问题,腾讯云基于数据万象推出面向具身智能行业的Robo-suite,它将数据预处理、质检、拆分、标注、重建和脱敏等能力整合起来,并利用大模型和云端算力提高数据处理的自动化程度。
在实际应用中,这些能力已经取得了一定效果。程力介绍,相关具身智能客户通过Robo-suite及在线标注能力,将数据标注效率提升了5至10倍。数据处理效率的提升,可以帮助模型团加快模型迭代。
最后是让训练数据更快地进入GPU集群。
大模型训练通常需要大量GPU同时读取数据,如果存储系统无法及时提供数据,即使GPU计算能力很强,也只能原地等待,造成巨大的资源浪费。
为此,腾讯云通过GooseFS数据加速器,在对象存储与计算集群之间建立高性能数据访问通道,让训练任务更高效地访问COS中的数据,从而减少数据访问对GPU计算效率的影响。
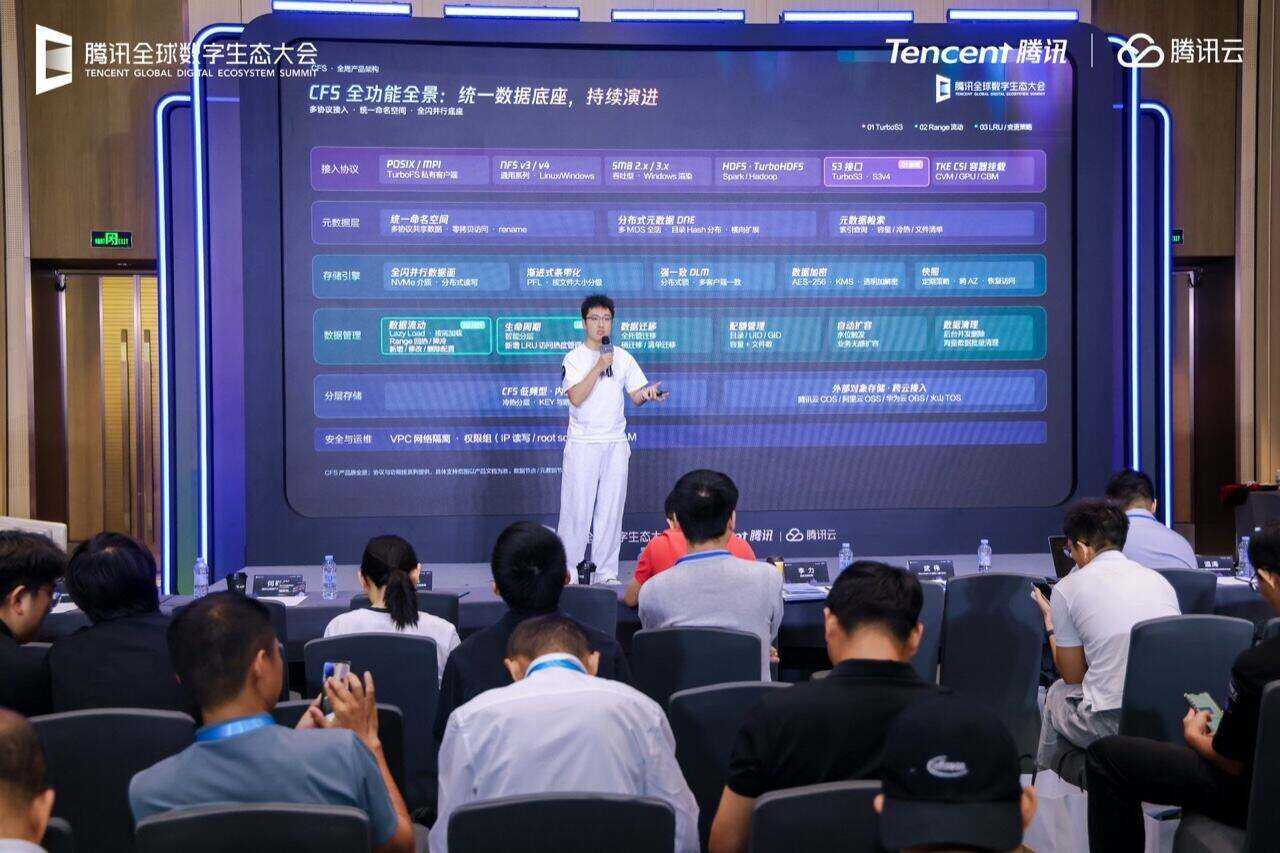
除了GooseFS,腾讯云还对AI数据引擎并行文件系统CFS Turbo进行了重磅升级。据腾讯云AI存储产品负责人杨飞介绍,并行文件系统CFS Turbo重点升级了多协议访问、数据流动和智能分层三大能力。
其中,多协议访问中,CFS Turbo可直接通过S3接口访问高性能并行文件系统,从而减少数据的重复搬迁。测试发现,CFS Turbo的S3访问吞吐相比传统对象存储方案提升数十倍,访问时延降低至约十分之一,QPS甚至能达到百万级。
除了计算和存储以外,大规模AI训练和推理也都离不开高速网络通信能力的配合。腾讯云专家还介绍了自研集合通信库HCCL来提高GPU集群内部的数据交换效率。在一个汽车企业的视觉语言模型训练案例中,HCCL将一轮训练的时间从约12小时缩短至不足8小时。同时,搭配腾讯云的AI Link一张网解决方案,还可通过全球网络资源调度和传输加速,帮助企业高效利用分布在不同地区的算力、数据与模型。
结语
从Agent的云端托管,到国产GPU的适配与训练加速,再到海量数据的存储、处理和高效供给,腾讯云此次展示的技术与产品升级,覆盖了AI应用从部署运行到模型训练、数据管理的多个关键环节。
随着智能体的发展,随着AI从一步走向物理世界,云基础设施需要承担更多复杂工作。通过持续完善计算、存储和网络能力,腾讯云正在为大模型、Agent和具身智能的规模化应用提供更加完整的基础设施支持。